Bioinformatikgestützte genomische Interpretation

Genetische Daten in aussagekräftige biologische Erkenntnisse umwandeln
Die rasante Entwicklung genomischer Technologien hat die Menge der Forschenden zur Verfügung stehenden genetischen Informationen erheblich erweitert. Moderne Sequenzierungsplattformen erzeugen umfangreiche Datensätze, deren Verarbeitung, Analyse und biologische Interpretation spezialisierte computergestützte Methoden erfordern.
Die bioinformatikgestützte genomische Interpretation verbindet Informatik, Molekularbiologie und statistische Verfahren, um komplexe genetische Daten in aussagekräftige biologische Informationen umzuwandeln. Durch die Integration von Sequenzanalysen, genomischer Annotation, vergleichenden Untersuchungen und Datenvisualisierung können Forschende genetische Strukturen untersuchen und molekulare Muster identifizieren, die mit biologischen Prozessen in Zusammenhang stehen.
Dieser integrierte Ansatz unterstützt wissenschaftliche Untersuchungen in den Bereichen Molekulargenetik, Biotechnologie, Mikrobiologie, biomedizinische Forschung und pharmazeutische Entwicklung.
Die Grundlagen der genomischen Bioinformatik verstehen
Die genomische Bioinformatik umfasst die Anwendung computergestützter Werkzeuge und analytischer Methoden zur Untersuchung genetischer Informationen. Sie ermöglicht es Forschenden, große Mengen an DNA- und RNA-Sequenzdaten zu organisieren, zu verarbeiten, miteinander zu vergleichen und zu interpretieren.
Der Prozess beginnt mit der Erzeugung molekularer Informationen mithilfe von Sequenzierungstechnologien. Die Rohdaten der Sequenzierung werden anschließend bewertet, verarbeitet und mithilfe spezialisierter computergestützter Analysepipelines untersucht.
Mehrere grundlegende Arbeitsschritte tragen zur genomischen Interpretation bei:
Verarbeitung und Qualitätsbewertung von Sequenzierungsdaten.
Identifizierung und Vergleich genetischer Sequenzen.
Genomassemblierung und strukturelle Charakterisierung.
Erkennung genetischer Variationen.
Funktionelle Annotation genomischer Regionen.
Interpretation biologischer Muster durch computergestützte Analysen.
Diese Arbeitsschritte bilden einen strukturierten Rahmen für die Untersuchung genetischer Informationen und das Verständnis ihrer möglichen biologischen Bedeutung.
Verarbeitung genomischer Daten und Qualitätskontrolle
Eine zuverlässige genomische Interpretation beginnt mit der Bewertung der Qualität von Sequenzierungsdaten. Rohdaten können technische Fehler, Sequenzabschnitte mit niedriger Qualität, Adaptersequenzen oder andere Elemente enthalten, die nachfolgende Analysen beeinflussen können.
Qualitätskontrollwerkzeuge unterstützen Forschende dabei, die Sequenzierungsgenauigkeit zu bewerten, mögliche technische Einschränkungen zu erkennen und festzustellen, ob Datensätze für weitere Untersuchungen geeignet sind.
Zu den häufig verwendeten bioinformatischen Werkzeugen gehören:
FastQC: Bewertet die Sequenzierungsqualität anhand verschiedener Parameter, darunter Basenqualitätswerte, GC-Gehalt, Sequenzduplikationen und Adapterkontaminationen.
fastp: Unterstützt die Qualitätsfilterung, das Entfernen von Adaptersequenzen und die Vorverarbeitung von Sequenzierungsdaten.
MultiQC: Fasst Qualitätskontrollberichte aus verschiedenen Analysewerkzeugen in einer übersichtlichen Gesamtdarstellung zusammen.
Diese Vorverarbeitungsverfahren tragen zu einer höheren Datenkonsistenz bei und verbessern die Zuverlässigkeit nachfolgender genomischer Analysen.
Sequenzalignment und Genom-Mapping
Das Sequenzalignment ist ein wesentlicher Bestandteil der genomischen Bioinformatik. Dabei werden Nukleotidsequenzen miteinander verglichen, um Ähnlichkeiten, Unterschiede und Beziehungen zwischen genetischen Regionen zu identifizieren.
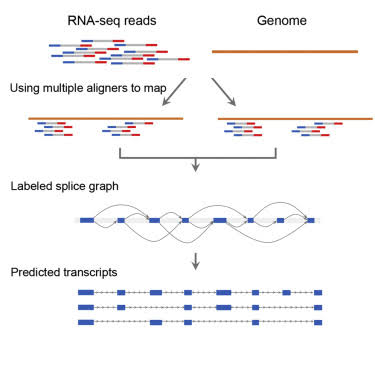
Beim referenzbasierten Alignment werden Sequenzierungsreads einem etablierten Referenzgenom zugeordnet. Dieser Prozess ermöglicht es Forschenden, den genomischen Ursprung einzelner Reads zu bestimmen und mögliche genetische Variationen zu erkennen.
Hierfür werden verschiedene spezialisierte Werkzeuge eingesetzt:
BWA: Ermöglicht die effiziente Zuordnung von Sequenzierungsreads zu Referenzgenomen.
Bowtie2: Unterstützt ein schnelles und präzises Alignment kurzer DNA-Sequenzierungsreads.
HISAT2: Bietet Alignment-Funktionen für RNA-Sequenzierungsdaten, einschließlich spleißbewusster Zuordnungsverfahren.
STAR: Ermöglicht ein leistungsfähiges Alignment von RNA-Sequenzierungsreads über Exon-Exon-Grenzen hinweg.
Die daraus resultierenden Alignment-Dateien bilden eine wichtige Grundlage für die Erkennung genetischer Varianten, transkriptomische Untersuchungen und die genomische Charakterisierung.
Genomassemblierung und Strukturanalyse
Die Genomassemblierung umfasst die Rekonstruktion längerer genomischer Sequenzen aus kleineren Sequenzierungsfragmenten. Dieser Prozess ist besonders wichtig bei der Untersuchung von Organismen ohne vollständiges Referenzgenom oder bei der Analyse bislang nicht charakterisierten genetischen Materials.
De-novo-Assemblierungsverfahren ordnen Sequenzierungsreads zu längeren zusammenhängenden Sequenzen, sogenannten Contigs, an. Diese können anschließend zu größeren Sequenzstrukturen, den sogenannten Scaffolds, verbunden werden.
Je nach Sequenzierungstechnologie und Forschungsziel kann die Genomassemblierung durch Werkzeuge wie SPAdes, MEGAHIT und Flye unterstützt werden.
Die Strukturanalyse trägt außerdem zum Verständnis der genomischen Organisation bei. Dazu gehören die Verteilung von Genen, repetitive Elemente und größere genetische Regionen.
Gemeinsam liefern Assemblierung und strukturelle Charakterisierung wertvolle Informationen zur Untersuchung der Genomarchitektur und biologischen Vielfalt.

Erkennung und Interpretation genetischer Varianten
Genetische Variationen bezeichnen Unterschiede in Nukleotidsequenzen zwischen Individuen, Populationen oder biologischen Proben. Bioinformatische Methoden helfen dabei, diese Unterschiede zu identifizieren und ihre mögliche biologische Bedeutung zu untersuchen.
Pipelines zur Variantenerkennung können folgende Bereiche umfassen:
Einzelnukleotidvarianten.
Kleine Insertionen und Deletionen.
Kopienzahlvariationen.
Strukturelle genomische Veränderungen.
Unterschiede zwischen genetischen Sequenzen verschiedener Proben.
Werkzeuge wie GATK, FreeBayes und bcftools unterstützen unterschiedliche Phasen der Variantenerkennung und -analyse.
Nach der Identifizierung können Varianten mithilfe genomischer Datenbanken und spezialisierter Software annotiert werden. Dieser Prozess liefert Informationen über ihre genomische Position, mögliche funktionelle Auswirkungen und bereits dokumentierte Zusammenhänge.
Die Interpretation erfordert eine sorgfältige Berücksichtigung der Sequenzierungsqualität, der Auswahl des Referenzgenoms, des biologischen Kontexts und der Einschränkungen verfügbarer Datenbanken.
Funktionelle genomische Annotation
Die genomische Annotation dient dazu, biologische Merkmale innerhalb genetischer Sequenzen zu identifizieren und zu beschreiben. Sie hilft Forschenden, die Position von Genen, regulatorischen Elementen, kodierenden Regionen und weiteren genomischen Bestandteilen zu bestimmen.
Die funktionelle Annotation verbindet genetische Informationen mit biologischem Wissen, indem sie Genfunktionen, molekulare Wechselwirkungen und zugehörige biologische Signalwege untersucht.
Verschiedene Ressourcen unterstützen diesen Prozess:
Ensembl: Bietet genomische Informationen, Genannotationen und Ressourcen für vergleichende Genomanalysen.
NCBI: Stellt umfangreiche biologische Datenbanken und Sequenzinformationen bereit.
UniProt: Bietet detaillierte Informationen zu Proteinsequenzen und deren Funktionen.
Gene Ontology: Strukturiert biologisches Wissen in molekulare Funktionen, zelluläre Komponenten und biologische Prozesse.
KEGG: Unterstützt die Untersuchung molekularer Signalwege und biologischer Netzwerke.
Diese Ressourcen ermöglichen es Forschenden, über die reine Sequenzidentifizierung hinauszugehen und die mögliche biologische Bedeutung genomischer Ergebnisse zu untersuchen.
RNA-Sequenzierung und Genexpressionsanalyse
Die RNA-Sequenzierung wird häufig zur Untersuchung der Genexpression und der Transkriptvielfalt eingesetzt. Sie liefert Informationen über RNA-Moleküle, die unter bestimmten experimentellen Bedingungen in biologischen Proben vorhanden sind.
Ein typischer RNA-Sequenzierungsworkflow umfasst die Qualitätsbewertung der RNA, die Vorbereitung der Sequenzierungsbibliothek, die Sequenzierung, das Alignment oder die Quantifizierung der Reads sowie die statistische Auswertung.
Computergestützte Werkzeuge wie HISAT2, STAR, featureCounts, Salmon und DESeq2 unterstützen unterschiedliche Phasen der transkriptomischen Analyse.
Die Analyse differentieller Genexpression kann Veränderungen der Transkripthäufigkeit zwischen experimentellen Gruppen aufzeigen. Diese Ergebnisse helfen Forschenden, zelluläre Reaktionen, biologische Signalwege und molekulare Mechanismen zu untersuchen.
Die Integration transkriptomischer Daten mit genomischen Informationen ermöglicht ein umfassenderes Verständnis darüber, wie genetische Informationen reguliert und exprimiert werden.

Statistische Analyse und Datenvisualisierung integrieren
Genomische Datensätze enthalten häufig Tausende oder Millionen von Messwerten. Statistische Analysen sind daher unerlässlich, um aussagekräftige Muster zu identifizieren und biologische Beobachtungen von technischen Schwankungen zu unterscheiden.
Die computergestützte Analyse kann Normalisierung, statistische Tests, Clusteranalysen, Dimensionsreduktion und prädiktive Modellierung umfassen.
Datenvisualisierungswerkzeuge erleichtern die Darstellung komplexer Ergebnisse durch grafische Formate wie Heatmaps, Volcano-Plots, Hauptkomponentenanalyse, genomische Abdeckungsdiagramme und phylogenetische Bäume.
Plattformen und Programmierumgebungen wie R, Python, Bioconductor und spezialisierte genomische Visualisierungssoftware unterstützen die Untersuchung und Präsentation genomischer Ergebnisse.
Die Kombination statistischer Methoden mit einer übersichtlichen Visualisierung verbessert die Dateninterpretation und erleichtert die Kommunikation zwischen computergestützt arbeitenden Forschenden und experimentell tätigen Wissenschaftlern.
Herausforderungen bei der Interpretation genomischer Daten
Trotz bedeutender technologischer Fortschritte bringt die genomische Bioinformatik verschiedene analytische und methodische Herausforderungen mit sich.
Große Datensätze erfordern erhebliche Rechenressourcen, geeignete Strategien für das Datenmanagement und sorgfältig entwickelte Analysepipelines. Unterschiede zwischen Sequenzierungstechnologien, Referenzgenomen und Verarbeitungsparametern können ebenfalls die analytischen Ergebnisse beeinflussen.
Zu den wichtigsten Aspekten gehören:
Sicherstellung der Qualität und Konsistenz von Sequenzierungsdaten.
Auswahl geeigneter Referenzgenome und Datenbanken.
Kontrolle analytischer Verzerrungen und technischer Variabilität.
Gewährleistung der Reproduzierbarkeit computergestützter Arbeitsabläufe.
Interpretation genetischer Variationen im biologischen Kontext.
Verantwortungsbewusster Umgang mit sensiblen genomischen Informationen.
Dokumentation von Softwareversionen und analytischen Parametern.
Die Bewältigung dieser Herausforderungen erfordert eine enge Zusammenarbeit zwischen Molekularbiologen, Genetikern, Bioinformatikern und weiteren wissenschaftlichen Fachkräften.
Zukunftsperspektiven der computergestützten Genomik
Die Zukunft der genomischen Interpretation ist eng mit Fortschritten in den Bereichen künstliche Intelligenz, maschinelles Lernen, Long-Read-Sequenzierung und Hochleistungsrechnen verbunden.
Neue computergestützte Ansätze verbessern die Möglichkeiten zur Analyse komplexer genomischer Strukturen, zur Untersuchung regulatorischer Mechanismen und zur Integration verschiedener biologischer Datentypen.
Die Kombination von Genomik, Transkriptomik, Proteomik und Metabolomik ermöglicht zudem umfassendere Untersuchungen biologischer Systeme.
Mit der kontinuierlichen Weiterentwicklung der Sequenzierungstechnologien wird die Bioinformatik weiterhin eine zentrale Rolle dabei spielen, umfangreiche genetische Datensätze in wissenschaftlich aussagekräftiges Wissen umzuwandeln.